100% seguro
| No requiere suscripción | Sin malware

Si buscas una API de voz a texto gratis para integrar transcripción en una aplicación, conviene distinguir entre tres modelos: niveles gratuitos mensuales, créditos de prueba para cuentas nuevas y servicios de pago por uso. La mayoría de las API de reconocimiento de voz no son gratuitas de forma ilimitada, pero sí permiten probar la transcripción sin asumir un coste inicial elevado.
Google Cloud Speech-to-Text, Azure AI Speech, Speechmatics, AssemblyAI y Amazon Transcribe cubren necesidades distintas: audio pregrabado, transcripción en tiempo real, varios idiomas, diarización de hablantes o integración con infraestructuras cloud. La mejor opción depende del volumen de audio, el tipo de transcripción y las funciones que necesite tu aplicación.
 Descarga segura | Sin malware
En este artículo
Comparativa de API de voz a texto con opción gratuita
Antes de elegir una API, revisa qué significa exactamente “gratis” en cada proveedor. Algunos ofrecen una cuota mensual permanente, otros limitan la oferta a cuentas nuevas y otros entregan créditos que se consumen según el modelo seleccionado.
| API | Opción gratuita actual | Transcripción | Más adecuada para |
| Google Cloud Speech-to-Text | V1: primeros 60 min/mes sin coste | Tiempo real y audio pregrabado | Aplicaciones dentro del ecosistema Google Cloud |
| Azure AI Speech | F0: 5 h/mes de transcripción en tiempo real | Tiempo real; el nivel F0 no incluye batch | Proyectos que ya utilizan Azure o necesitan personalización de voz |
| Speechmatics | Créditos gratuitos para empezar | Tiempo real y audio pregrabado | Audio multilingüe y proyectos que necesitan cambiar de idioma dentro de una misma grabación |
| AssemblyAI | Nivel gratuito sin tarjeta para probar sus modelos | Tiempo real y audio pregrabado | Diarización, transcripción conversacional y aplicaciones de Voice AI |
| Amazon Transcribe | 60 min/mes durante 12 meses | Streaming y audio pregrabado | Aplicaciones integradas con servicios de AWS |
No elijas únicamente por el número de minutos gratuitos. Para una integración real también importan la latencia, los idiomas compatibles, la diarización, la personalización de vocabulario, la región de procesamiento, el almacenamiento necesario y el coste después de agotar el nivel gratuito.
1. Google Cloud Speech-to-Text
Google Cloud Speech-to-Text convierte audio en texto mediante las API de Google Cloud y ofrece modelos para audio corto, conversaciones, llamadas y video. También incluye la familia Chirp dentro de Speech-to-Text V2 para reconocimiento multilingüe.
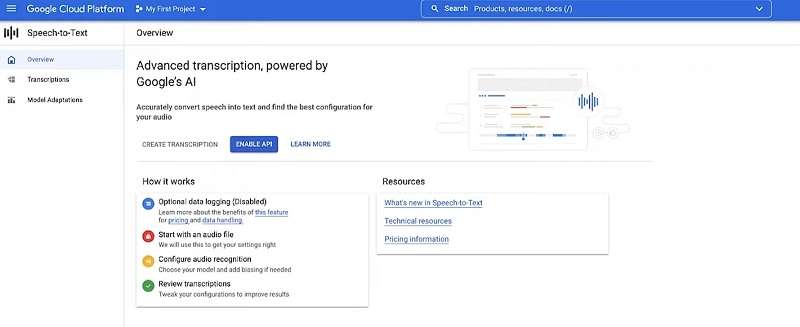
Opción gratuita: en Speech-to-Text V1, los primeros 60 minutos de reconocimiento estándar al mes tienen coste cero. En V2, la tarifa depende del modelo y del método de procesamiento, por lo que no conviene asumir que el mismo tramo gratuito se aplica a todas las versiones.
- Admite transcripción de audio pregrabado y reconocimiento en streaming.
- Incluye modelos de reconocimiento adaptados a distintos tipos de audio.
- Permite mejorar el reconocimiento de términos mediante funciones de adaptación y contexto.
- Encaja bien en arquitecturas que ya utilizan Google Cloud.
Puede resultar menos directo para un prototipo pequeño si todavía no utilizas Google Cloud, ya que tendrás que configurar proyecto, facturación, autenticación y cuotas antes de pasar a producción.
2. Azure AI Speech
Azure AI Speech incluye reconocimiento de voz en tiempo real, transcripción por lotes en planes compatibles y funciones de personalización mediante Custom Speech. Forma parte de los servicios de IA de Microsoft Azure.
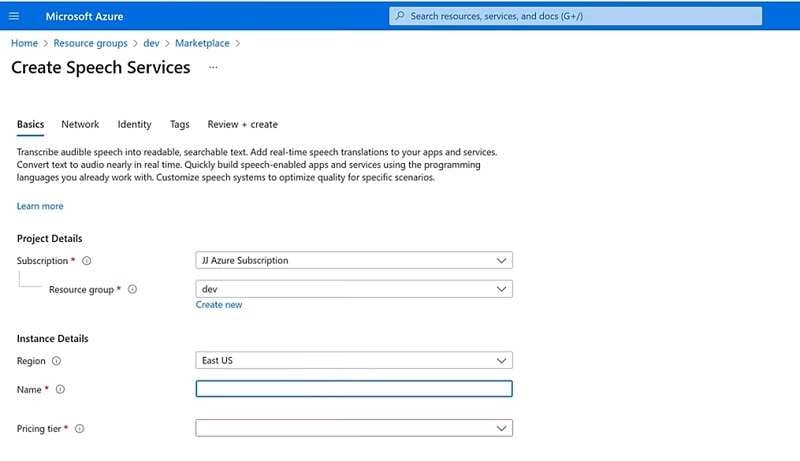
Opción gratuita: el nivel F0 ofrece actualmente hasta 5 horas de audio al mes para transcripción en tiempo real. Esta cuota se comparte entre Speech-to-Text estándar y personalizado; la transcripción por lotes no está incluida en F0.
- Transcribe audio en tiempo real desde aplicaciones y servicios conectados.
- Permite trabajar con modelos personalizados y vocabulario específico.
- Se integra con almacenamiento y otros servicios de Azure.
- Resulta especialmente útil cuando la aplicación ya utiliza infraestructura de Microsoft.
La principal barrera para proyectos pequeños suele ser la configuración inicial del entorno Azure. Además, si necesitas batch transcription, tendrás que utilizar un nivel compatible distinto del plan F0.
3. Speechmatics
Speechmatics ofrece API para audio pregrabado y transcripción en tiempo real. Sus modelos actuales incluyen opciones multilingües capaces de reconocer decenas de idiomas y cambiar de idioma dentro de una misma conversación.
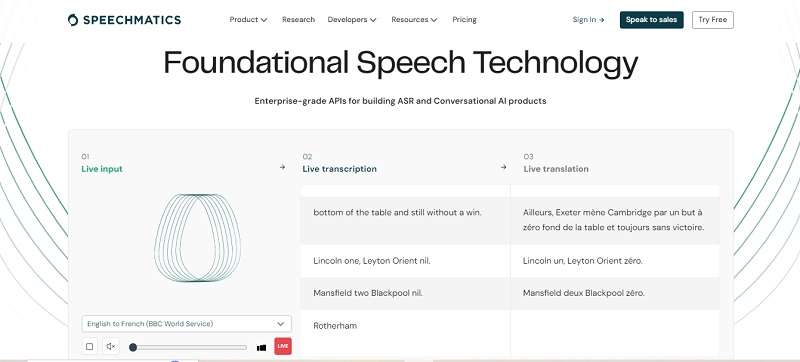
Opción gratuita: el antiguo sistema de horas gratuitas mensuales dejó de ser la referencia principal. Speechmatics utiliza ahora un sistema basado en créditos y las cuentas nuevas pueden empezar con 100 USD en créditos sin introducir una tarjeta.
- Modelos para transcripción pregrabada y en tiempo real.
- Buen enfoque para contenido multilingüe y cambio de idioma durante la conversación.
- Marcas de tiempo y funciones útiles para subtítulos y procesamiento posterior.
- Modelo de pago por uso una vez agotados los créditos.
Los créditos son adecuados para evaluar la API, pero no equivalen a una cuota gratuita recurrente. Para un proyecto continuo, calcula el consumo con el modelo y las funciones adicionales que realmente vayas a utilizar.
4. AssemblyAI
AssemblyAI está orientada a desarrolladores que trabajan con transcripción, audio conversacional y aplicaciones de Voice AI. Sus modelos actuales cubren audio pregrabado, streaming y clips cortos mediante diferentes endpoints.
Opción gratuita: actualmente permite crear una cuenta sin tarjeta y empezar con un nivel gratuito. La oferta vigente incluye capacidad gratuita para probar tanto transcripción pregrabada como streaming antes de pasar al modelo de pago por uso.
- Universal-2 ofrece cobertura para 99 idiomas.
- Los modelos Pro priorizan mayor precisión y capacidades conversacionales en un grupo más reducido de idiomas.
- Permite añadir diarización de hablantes, identificación de entidades y otras funciones de comprensión del audio.
- Dispone de APIs separadas para transcripción asíncrona, streaming y clips cortos.
Algunas funciones avanzadas se facturan como complementos, por lo que conviene comparar el coste total y no solo la tarifa base de Speech-to-Text.
5. Amazon Transcribe
Amazon Transcribe forma parte de AWS y puede procesar audio pregrabado o streams de audio en tiempo real. Incluye vocabularios personalizados, identificación de hablantes y opciones específicas para conversaciones y centros de contacto.
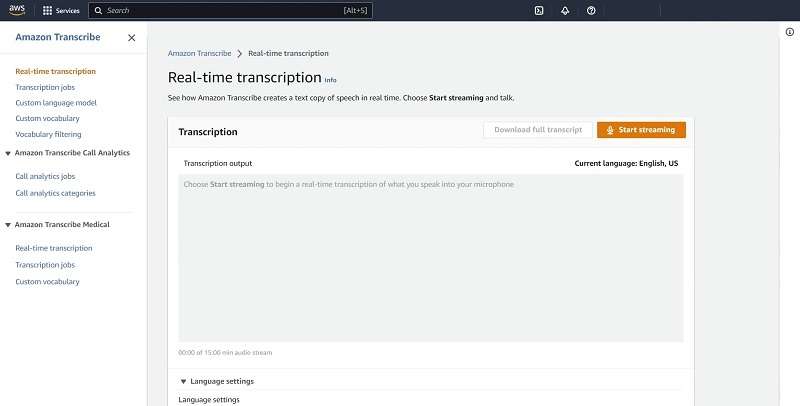
Opción gratuita: AWS ofrece hasta 60 minutos al mes durante los primeros 12 meses, contados desde la primera solicitud de transcripción que activa el Free Tier de Amazon Transcribe.
- Admite audio pregrabado y transcripción en streaming.
- Incluye vocabulario personalizado y filtrado de términos.
- Puede identificar distintos hablantes en una conversación.
- Se integra de forma natural con almacenamiento y servicios de AWS.
Para trabajos batch con archivos pregrabados es habitual combinar Amazon Transcribe con Amazon S3. Si tu infraestructura no utiliza AWS, esa dependencia adicional puede hacer que otra API resulte más sencilla de probar.

Cómo integrar una API de voz a texto
La implementación concreta cambia entre proveedores, pero el proceso suele seguir la misma secuencia. Antes de escribir código, define si vas a procesar archivos completos o audio en tiempo real y revisa qué funciones necesitas además de la transcripción básica.
Paso 1Crea una cuenta y un proyecto
Regístrate con el proveedor y crea el proyecto o recurso que utilizará la API. En servicios cloud también tendrás que revisar la región, las cuotas y la configuración de facturación.
Paso 2Activa Speech-to-Text y revisa el nivel gratuito
Habilita el servicio de reconocimiento de voz y confirma qué uso cubre realmente el plan gratuito. Comprueba si la cuota se aplica a streaming, batch, un modelo concreto o solo a cuentas nuevas.
Paso 3Configura la autenticación
Crea las credenciales necesarias para tu aplicación. Según el proveedor, puede tratarse de una clave API, un token o credenciales asociadas a una cuenta de servicio. No incluyas secretos directamente en código público o repositorios.
Paso 4Instala el SDK o utiliza REST
Puedes integrar la API mediante una biblioteca oficial para lenguajes como Python, JavaScript, Java o .NET, o enviar solicitudes directamente al endpoint REST cuando el proveedor lo permita.
Paso 5Prueba con una muestra corta de audio
Empieza con un archivo breve y representativo. Comprueba el idioma, la puntuación, los nombres propios, los tiempos y la identificación de hablantes antes de procesar grandes volúmenes.
Paso 6Controla errores, cuotas y coste
Registra el consumo y gestiona límites de concurrencia, reintentos y errores de red. Una prueba que funciona con unos minutos de audio puede comportarse de forma muy distinta cuando pasa a producción.
Voz a texto sin integrar una API: Filmora
Si no necesitas incorporar Speech-to-Text dentro de una aplicación y tu objetivo es generar subtítulos a partir de audio o video, una API puede añadir complejidad innecesaria. Filmora incluye Voz a texto dentro del editor para transcribir diálogo y generar subtítulos editables.
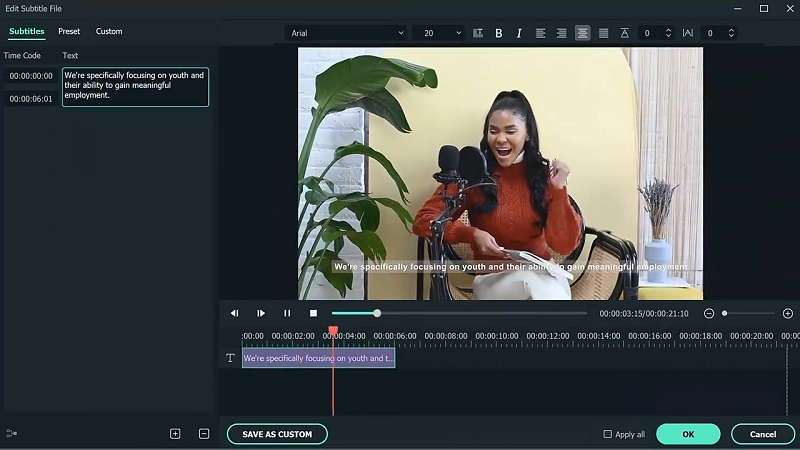
La función actual admite 45 idiomas, permite exportar subtítulos SRT y puede utilizar Corrección inteligente de texto para localizar posibles errores antes de publicar. También puede traducir los subtítulos a otros idiomas dentro del mismo flujo de edición.
Cuándo tiene más sentido Filmora que una API
- Subtítulos para video: necesitas transcribir, revisar y estilizar subtítulos dentro del mismo proyecto.
- Sin desarrollo: no quieres gestionar endpoints, autenticación, SDK, almacenamiento ni cuotas de API.
- Edición posterior: vas a seguir trabajando con el video, el audio, los títulos o la traducción después de transcribir.
- Uso puntual: necesitas convertir algunos archivos de audio o video en subtítulos y no construir una función dentro de una aplicación.
Descarga segura | Sin malware
Cómo convertir voz en texto con Filmora
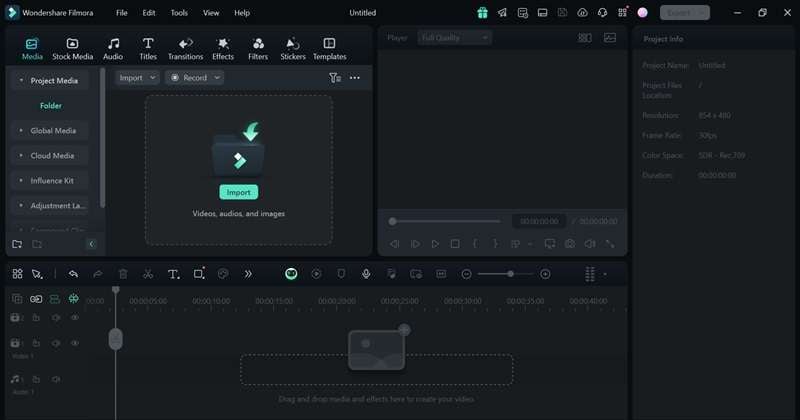
Paso 1Importa el audio o video
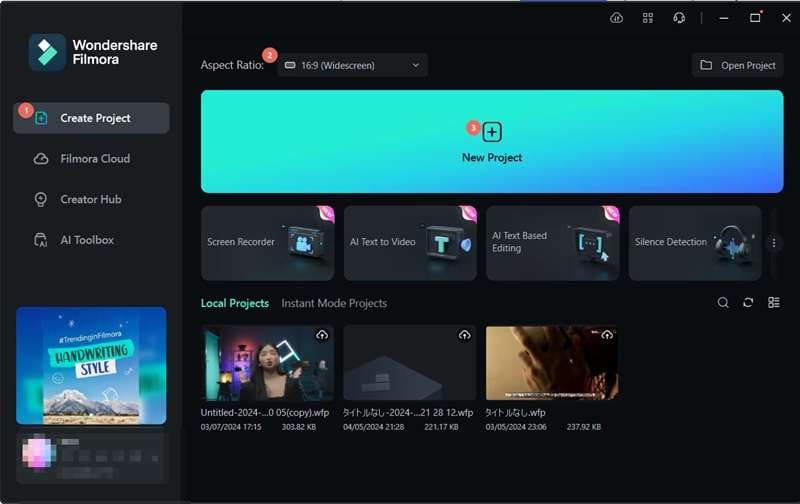
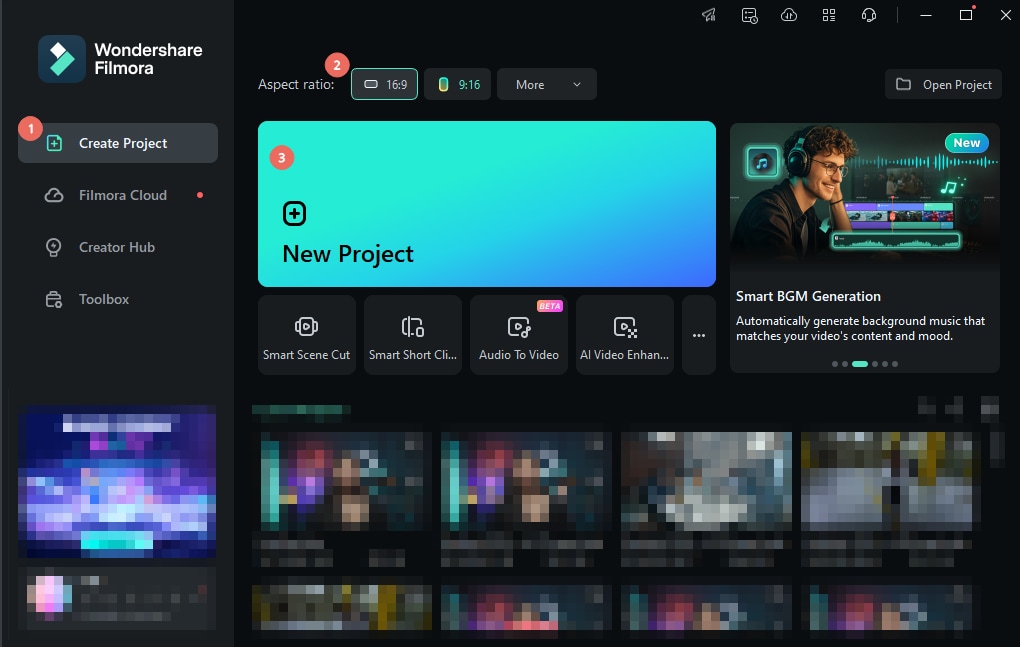
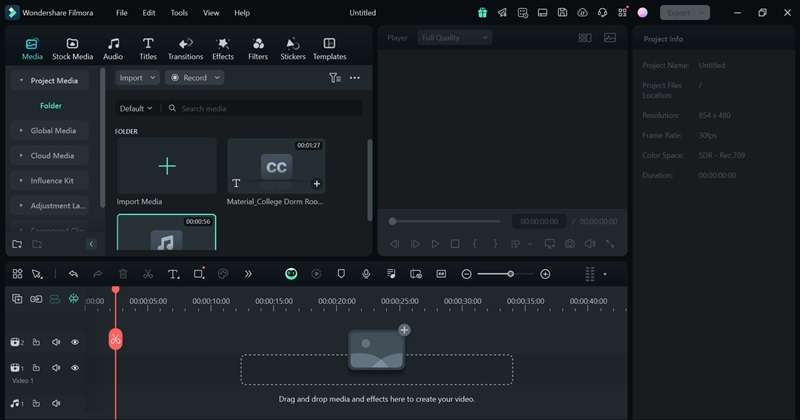
Abre Filmora, crea un proyecto e importa el archivo que quieras transcribir. Después, arrástralo a la línea de tiempo.
Paso 2Abre Voz a texto
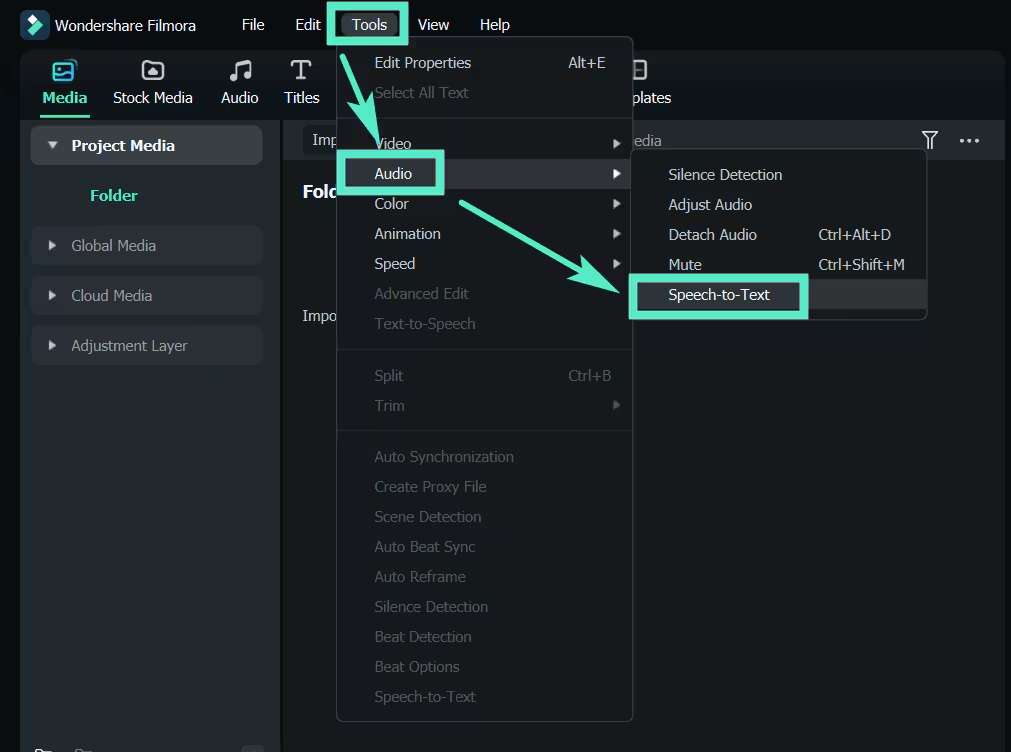
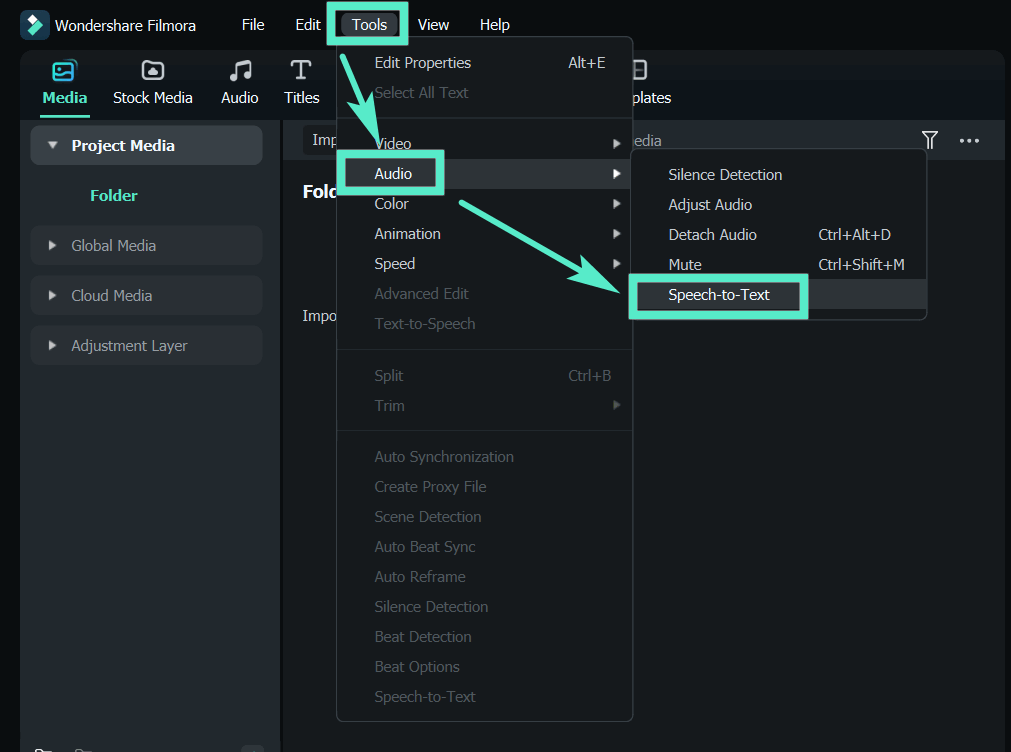
Selecciona el clip en la línea de tiempo y abre Voz a texto. En Windows puedes hacerlo desde el menú contextual del clip, desde Títulos > Subtítulos IA > Voz a texto o desde la barra de herramientas. En otros espacios de trabajo también puede aparecer en Herramientas > Audio > Voz a texto.
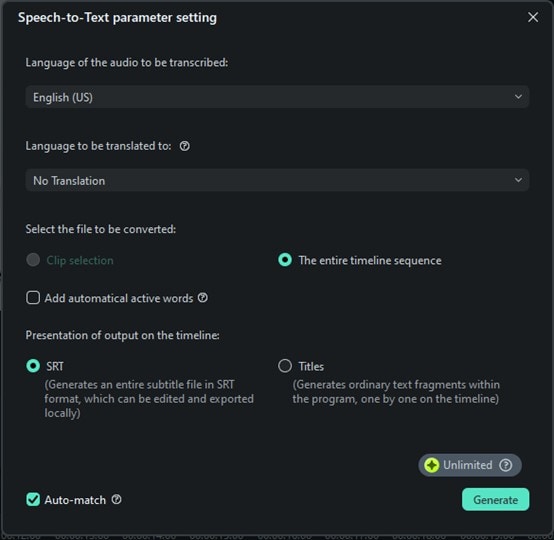
Paso 3Configura el idioma y la transcripción
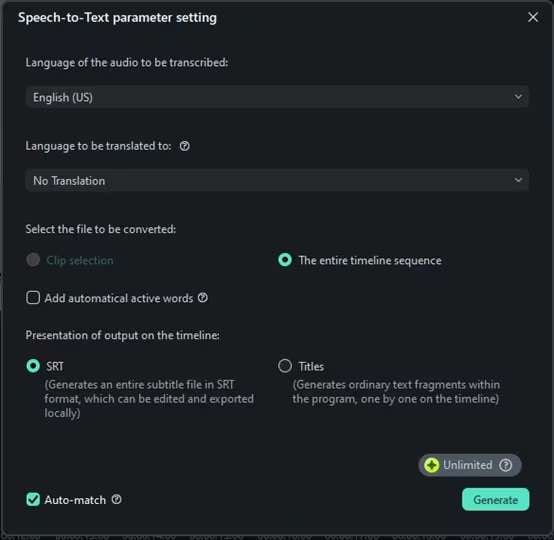
Selecciona el idioma del audio, configura la traducción si la necesitas y elige SRT como formato de salida cuando quieras trabajar con subtítulos. También puedes activar Corrección inteligente de texto para detectar posibles errores y revisar sugerencias antes de finalizar.
Paso 4Genera los subtítulos
Haz clic en Generar. Filmora procesará el audio y añadirá la transcripción para que puedas revisarla dentro del proyecto.
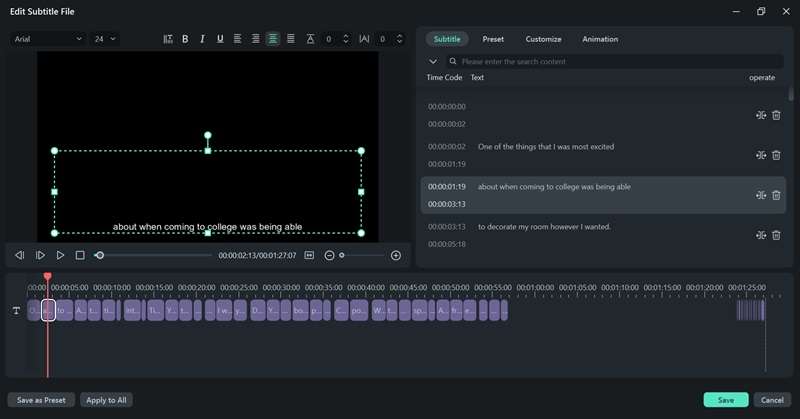
Paso 5Revisa y corrige el texto
Comprueba nombres propios, cifras, términos especializados y sincronización. Haz las correcciones necesarias antes de aplicar el estilo definitivo de los subtítulos.
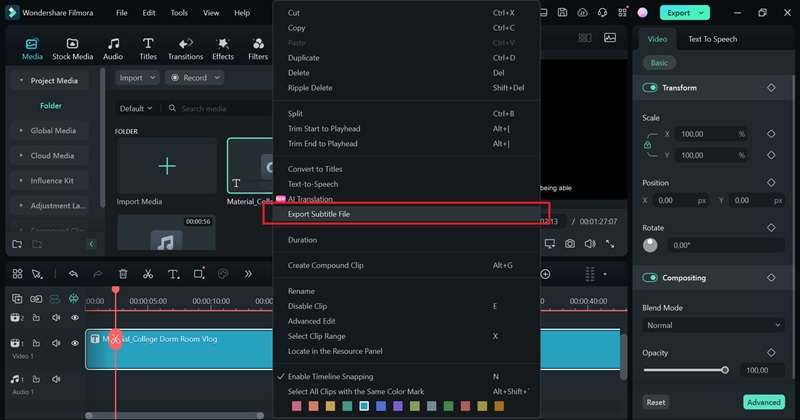
Paso 6Exporta el SRT o continúa editando
Puedes mantener los subtítulos dentro del proyecto y seguir editando el video o exportar el archivo de subtítulos en formato SRT para utilizarlo en otra plataforma.
Preguntas frecuentes sobre API de voz a texto gratis
-
¿Existe una API de voz a texto totalmente gratis?
Normalmente no de forma ilimitada. Los proveedores suelen ofrecer una cuota mensual, créditos de prueba o un Free Tier para cuentas nuevas. Cuando superas ese límite, la transcripción pasa a cobrarse por uso. -
¿Qué API de voz a texto tiene nivel gratuito?
Google Speech-to-Text V1, Azure AI Speech y Amazon Transcribe mantienen opciones gratuitas con límites específicos. Speechmatics y AssemblyAI permiten empezar con créditos o un nivel gratuito de prueba. Las condiciones pueden cambiar, por lo que conviene revisar el precio actual antes de integrar. -
¿Qué diferencia hay entre transcripción en tiempo real y por lotes?
La transcripción en tiempo real procesa el audio mientras se produce y prioriza la latencia. La transcripción por lotes trabaja con archivos ya grabados y suele ser más adecuada para entrevistas, reuniones, pódcast o grandes archivos de audio. -
¿Qué debo comparar además del precio?
Revisa idiomas, latencia, diarización, vocabulario personalizado, precisión con ruido, residencia de datos, límites de concurrencia, formatos compatibles y coste de las funciones adicionales. -
¿Necesito una API para convertir audio o video en subtítulos?
No. Si solo quieres generar subtítulos para contenido audiovisual, una herramienta como Filmora puede transcribir el audio directamente dentro del editor sin que tengas que programar una integración. -
¿Filmora Voz a texto es gratis?
La función utiliza créditos de IA. Actualmente, Voz a texto consume 4 créditos por minuto de audio procesado, por lo que su coste depende de los créditos disponibles en tu cuenta y del volumen que transcribas.