100% seguro
| No requiere suscripción | Sin malware

Hugging Face permite transcribir audio y convertir voz en texto de varias formas: puedes ejecutar un modelo de reconocimiento automático del habla en local con Transformers, usar Inference Providers para enviar el audio a una API o desplegar un Inference Endpoint dedicado para una aplicación en producción.
Para empezar con audio en español, un modelo multilingüe como Whisper suele ser más práctico que el antiguo ejemplo facebook/wav2vec2-large-960h, que está entrenado para inglés. Si solo necesitas generar subtítulos para un video y no quieres programar, Filmora ofrece un flujo de Voz a texto dentro del editor.
En este artículo
- Qué es el reconocimiento de voz en Hugging Face
- Qué opción de Hugging Face elegir
- Cómo transcribir audio en local con Transformers
- Cómo convertir voz en texto con la API de Hugging Face
- Cómo mejorar o personalizar la transcripción
- Voz a texto sin código con Filmora
- Hugging Face vs. Filmora
- Preguntas frecuentes
Qué es el reconocimiento de voz en Hugging Face
Hugging Face reúne modelos capaces de convertir voz en texto mediante reconocimiento automático del habla, conocido como ASR y también como Speech-to-Text. La biblioteca Transformers permite ejecutar muchos de estos modelos mediante la tarea automatic-speech-recognition.
Modelos como Whisper pueden reconocer varios idiomas y transcribir audio directamente. Wav2Vec2 sigue siendo una arquitectura importante para ASR, pero cada checkpoint tiene sus propios idiomas, datos de entrenamiento y requisitos. Por eso, el modelo debe elegirse según el idioma y el caso de uso, no solo por el nombre de la arquitectura.
| Concepto | Qué hace |
| Voz a texto / ASR | Convierte habla grabada o en streaming en texto. |
| Texto a voz / TTS | Hace el proceso contrario: convierte texto escrito en voz. |
| Traducción de voz | Reconoce el habla y genera texto en otro idioma cuando el modelo admite esa tarea. |

Qué opción de Hugging Face elegir para transcribir audio
Hugging Face ofrece distintas formas de ejecutar una transcripción. La elección depende de dónde quieres procesar el audio, cuánto control necesitas sobre el modelo y si prefieres gestionar la infraestructura.
| Opción | Procesamiento | Configuración | Más adecuada para |
| Transformers | En tu equipo o servidor | Python, dependencias y recursos de CPU/GPU | Pruebas locales, investigación y proyectos que necesitan controlar el modelo |
| Inference Providers | Remoto mediante proveedores de inferencia | Token de Hugging Face y cliente/API | Aplicaciones que quieren consumir modelos sin desplegarlos |
| Inference Endpoints | Endpoint dedicado administrado | Despliegue, instancia y configuración de endpoint | Servicios de producción que necesitan una infraestructura dedicada y escalable |
Si solo quieres probar un modelo público en local, no necesitas crear un token con permisos de escritura. Para llamar a Inference Providers, utiliza un token con los permisos de inferencia necesarios y evita conceder acceso de escritura cuando la aplicación no lo necesita.
Cómo transcribir audio en local con Hugging Face Transformers
La forma más directa de empezar es utilizar un pipeline de Transformers. Para audio en español, un modelo multilingüe como openai/whisper-small es un ejemplo más adecuado que facebook/wav2vec2-large-960h, ya que este último está ajustado con LibriSpeech para inglés.
Paso 1Instala Transformers y las dependencias
pip install -U transformers torch accelerate
Si vas a procesar formatos de audio que requieren decodificación adicional, como determinados MP3 o videos, comprueba también que FFmpeg esté disponible en tu sistema.
Paso 2Carga un modelo ASR
from transformers import pipeline

transcriber = pipeline(
    "automatic-speech-recognition",
    model="openai/whisper-small"
)
Whisper es multilingüe. Si el audio está en español, puedes indicar el idioma para evitar una detección innecesaria y mantener la tarea como transcripción.
Paso 3Transcribe el archivo de audio
result = transcriber(
    "audio.mp3",
    generate_kwargs={"language": "spanish", "task": "transcribe"}
)

print(result["text"])
El resultado contiene el texto reconocido. La calidad dependerá del modelo, el ruido de fondo, el acento, la claridad del habla y el tipo de audio.
Paso 4Trabaja con audio largo o marcas de tiempo
transcriber = pipeline(
    "automatic-speech-recognition",
    model="openai/whisper-small",
    chunk_length_s=30
)

result = transcriber("audio-largo.mp3", return_timestamps=True)
print(result["text"])
Dividir el audio en fragmentos ayuda a procesar grabaciones más largas. Las marcas de tiempo también son útiles cuando la transcripción se va a convertir en subtítulos.
Cómo convertir voz en texto con la API de Hugging Face
Si no quieres descargar y ejecutar el modelo en tu equipo, Hugging Face permite enviar solicitudes de inferencia a modelos compatibles mediante Inference Providers. El cliente de huggingface_hub puede encargarse de la autenticación y del envío del archivo.
Paso 1Crea una cuenta y un token de acceso
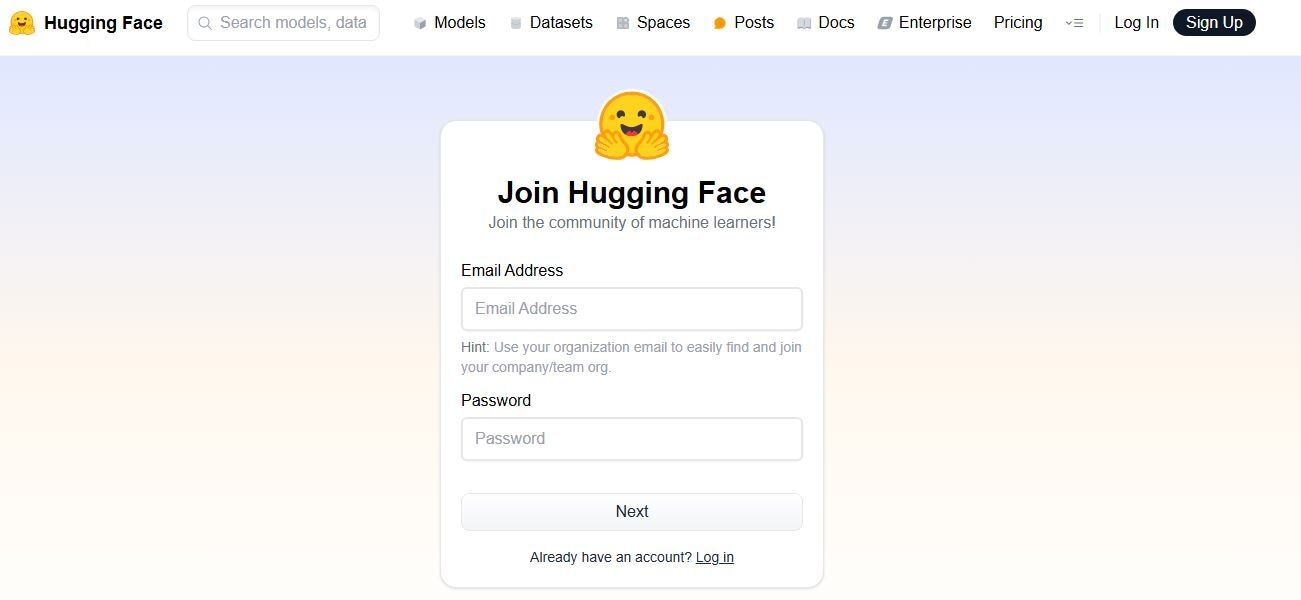
Crea un token desde la configuración de Hugging Face. Para Inference Providers, utiliza un token con permiso para realizar llamadas de inferencia y guárdalo como variable de entorno. No publiques el token dentro del código.
export HF_TOKEN="hf_..."
Paso 2Instala el cliente de Hugging Face
pip install -U huggingface_hub
Paso 3Envía el audio al modelo
import os
from huggingface_hub import InferenceClient

client = InferenceClient(
    provider="auto",
    api_key=os.environ["HF_TOKEN"]
)

result = client.automatic_speech_recognition(
    "audio.mp3",
    model="openai/whisper-large-v3"
)

print(result.text)
Con provider="auto", Hugging Face puede utilizar un proveedor disponible para el modelo. La disponibilidad concreta depende del modelo y de los proveedores que admitan reconocimiento de voz.
Cuándo utilizar Inference Endpoints
Inference Endpoints está pensado para desplegar modelos en infraestructura dedicada y administrada. Puede tener sentido cuando necesitas un endpoint estable para una aplicación, quieres elegir la infraestructura o necesitas escalar el servicio sin ejecutar el modelo en cada cliente.
Para un prototipo pequeño, empezar con Transformers en local o Inference Providers suele requerir menos configuración que desplegar un endpoint dedicado.
Cómo mejorar o personalizar la transcripción
No existe un único ajuste que mejore todos los audios. Antes de hacer fine-tuning, comprueba si el problema se resuelve eligiendo un modelo más adecuado para el idioma, utilizando mejor audio o ajustando la inferencia.
- Elige un modelo adecuado para el idioma. Un checkpoint entrenado solo con inglés no es la opción correcta para una transcripción en español.
- Prueba otro tamaño o familia de modelo. Whisper dispone de distintos checkpoints con requisitos y rendimiento diferentes.
- Usa fragmentación para audio largo. El parámetro
chunk_length_spermite procesar grabaciones extensas en partes. - Genera marcas de tiempo cuando necesites subtítulos.
return_timestamps=Truefacilita relacionar el texto con el audio. - Haz fine-tuning solo cuando tengas datos adecuados. Si necesitas mejorar el reconocimiento en un dominio, acento o conjunto de condiciones concreto, puedes entrenar un modelo compatible con tus propios pares de audio y transcripción.
Para evaluar cambios de modelo o fine-tuning, utiliza siempre el mismo conjunto de audio de prueba y compara los errores de reconocimiento. Así puedes saber si la personalización mejora realmente tu caso de uso.
Voz a texto sin código con Filmora
Hugging Face está pensado para quien necesita integrar o controlar modelos de reconocimiento de voz. Si tu objetivo es transcribir el audio de un video y generar subtítulos, una herramienta de escritorio evita tener que configurar Python, modelos o una API.
Voz a texto de Filmora genera subtítulos editables a partir del audio, admite actualmente 45 idiomas, permite exportar archivos SRT y ofrece Corrección inteligente de texto para localizar posibles errores antes de publicar.
 Descarga segura | Sin malware
Cómo convertir voz en texto con Filmora
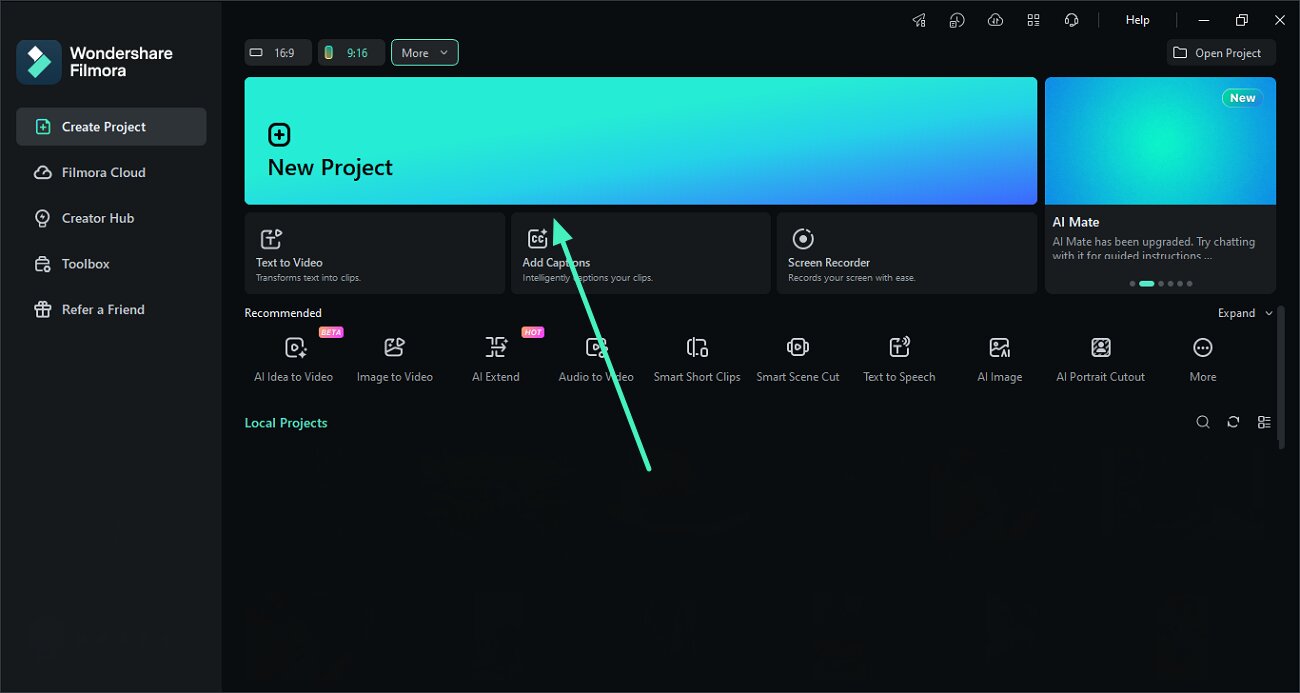
Paso 1Importa el audio o video
Abre Filmora, crea un proyecto e importa el archivo que quieras transcribir. Después, añádelo a la línea de tiempo.
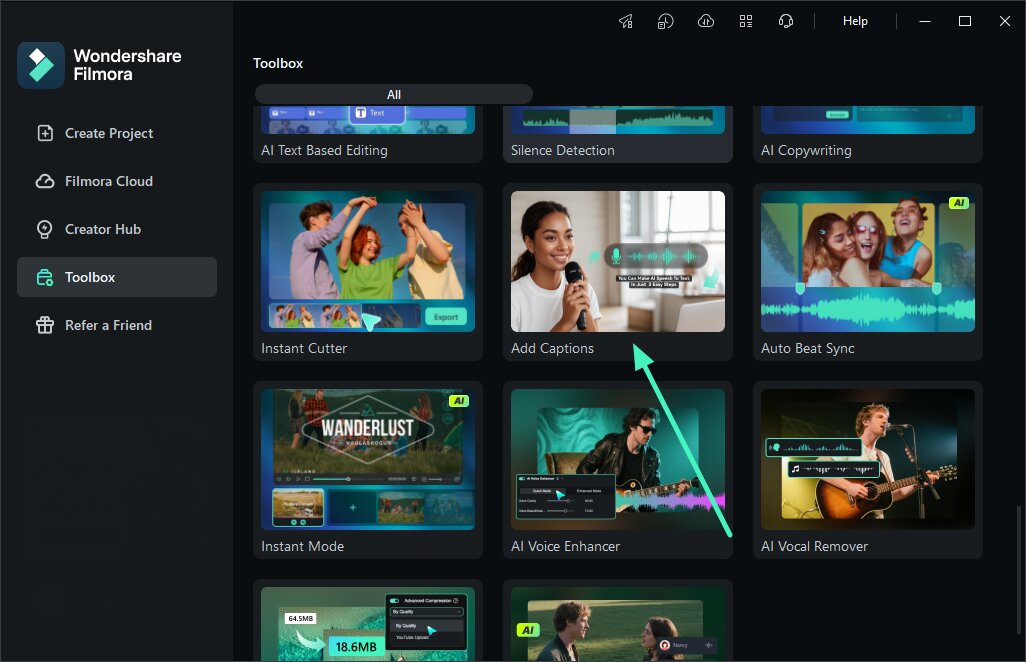
Paso 2Abre Voz a texto
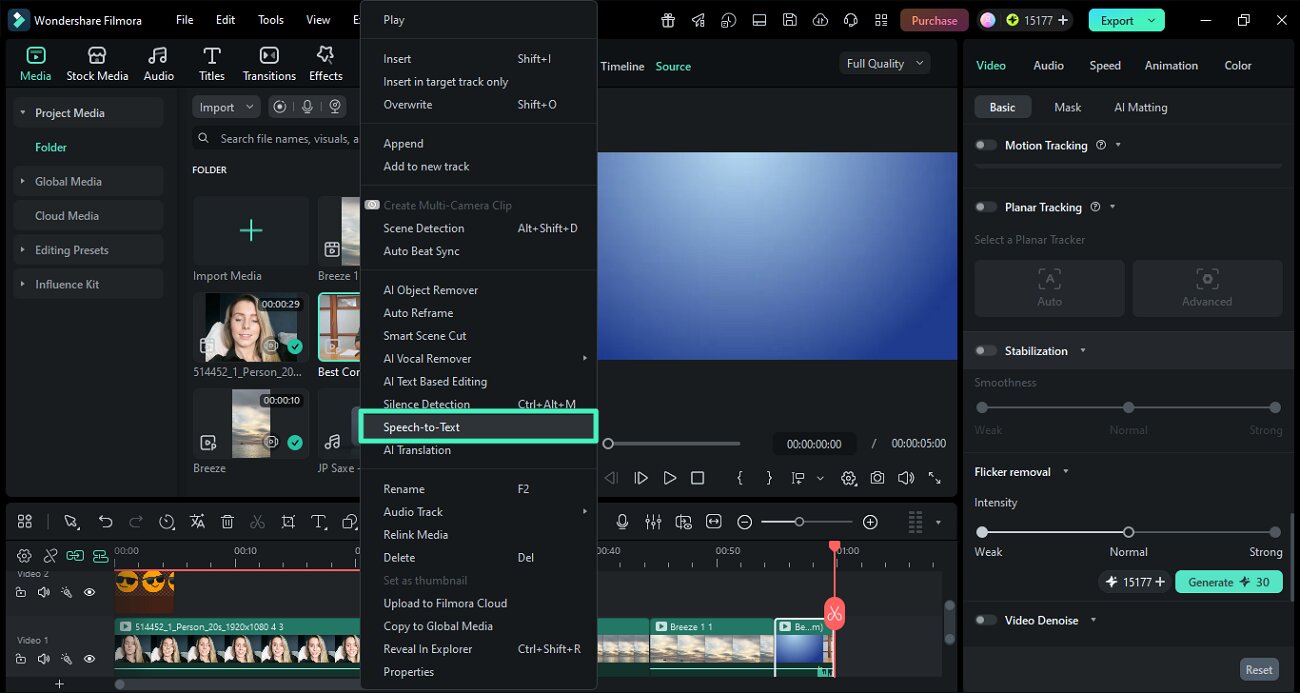
Selecciona el clip en la línea de tiempo, abre el menú contextual y elige Voz a texto. También puedes acceder a la función desde las opciones de subtítulos o la barra de herramientas.
Paso 3Configura el idioma y la transcripción
Selecciona el idioma del audio, configura la traducción si la necesitas y elige SRT como formato de salida cuando quieras trabajar con subtítulos.
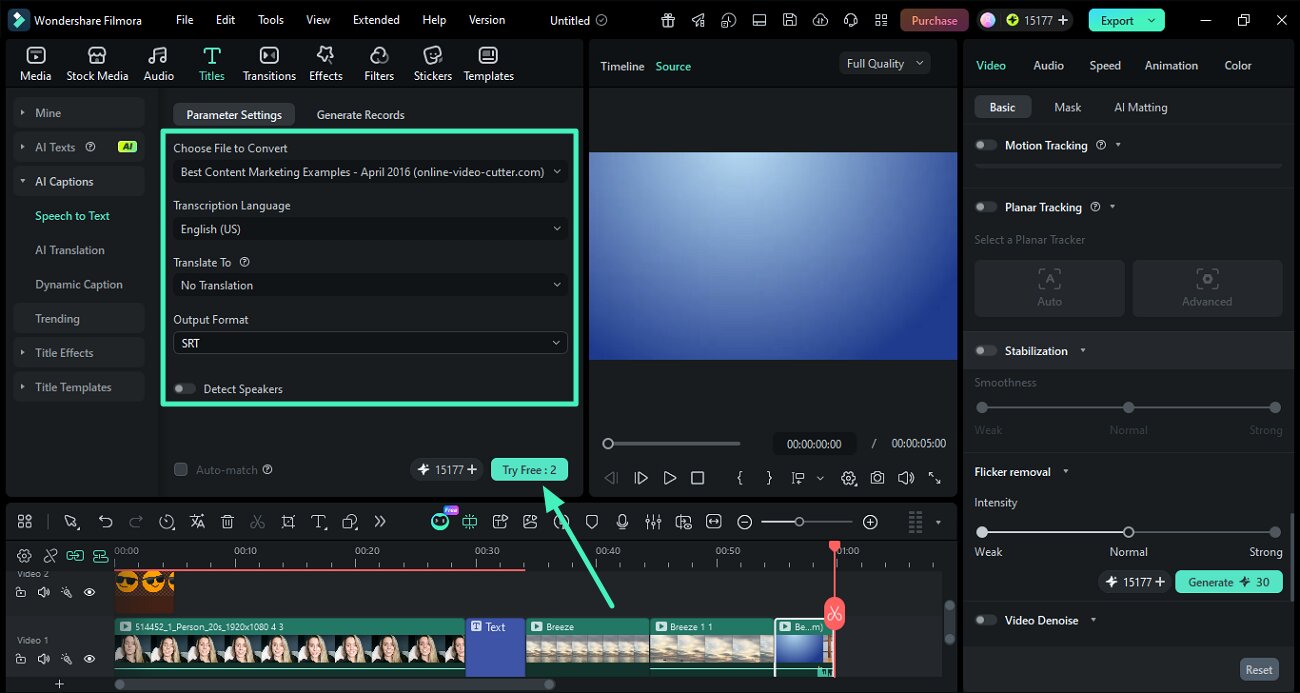
Paso 4Genera y revisa los subtítulos
Inicia la transcripción y revisa el resultado. Si activas Corrección inteligente de texto, Filmora puede señalar posibles errores para que los compruebes antes de terminar.
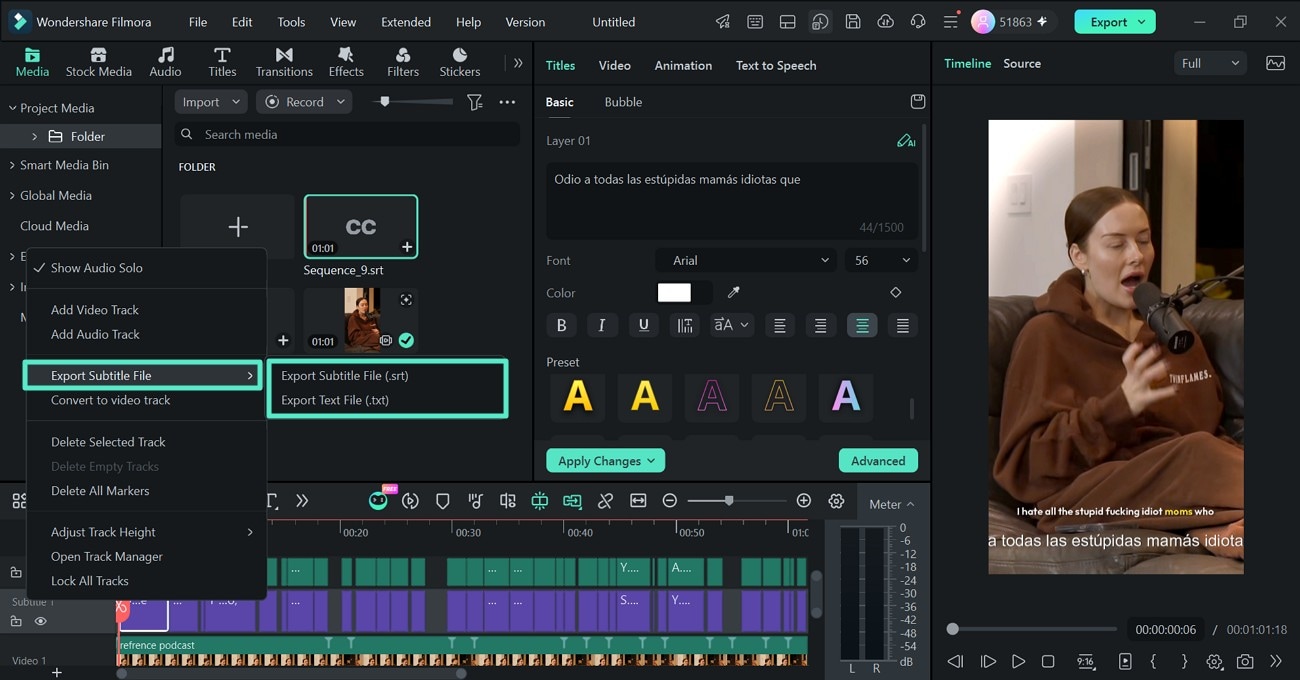
Paso 5Exporta el archivo de subtítulos
Si necesitas utilizar la transcripción en otra plataforma, haz clic con el botón derecho en la pista de subtítulos y selecciona Exportar archivo de subtítulos.
Hugging Face vs. Filmora: cuál elegir
Hugging Face y Filmora no compiten exactamente en el mismo tipo de tarea. Hugging Face es una plataforma para trabajar con modelos y servicios de IA; Filmora integra la transcripción dentro de un editor audiovisual.
| Criterio | Hugging Face | Filmora |
| Objetivo principal | Integrar, ejecutar o desplegar modelos de reconocimiento de voz | Generar y editar subtítulos dentro de un proyecto audiovisual |
| Programación | Normalmente necesaria para Transformers, APIs o endpoints | No necesaria para utilizar Voz a texto |
| Elección de modelos | Amplia variedad de modelos ASR y checkpoints del Hub | El modelo de transcripción está integrado en la función |
| Personalización técnica | Permite seleccionar modelos, ajustar inferencia y hacer fine-tuning cuando procede | Se centra en idioma, revisión, traducción y edición de subtítulos |
| Edición de video | No forma parte del flujo de ASR | Integrada en el mismo proyecto |
| Más adecuado para | Desarrolladores, investigación y productos que necesitan integrar transcripción automática | Creadores que quieren transcribir y editar contenido sin programar |
Elige Hugging Face si necesitas controlar el modelo, integrar la transcripción en una aplicación o desplegar tu propio servicio. Elige Filmora si la transcripción es una etapa de la edición de video y quieres generar, revisar y exportar subtítulos sin construir una integración técnica.
Preguntas frecuentes sobre voz a texto con Hugging Face
-
¿Hugging Face tiene una API para convertir voz en texto?
Sí. Puedes utilizar modelos de reconocimiento de voz mediante Inference Providers y, para una infraestructura dedicada, desplegar un modelo con Inference Endpoints. También puedes ejecutar modelos localmente con Transformers sin utilizar una API remota. -
¿Necesito una cuenta de Hugging Face para transcribir audio?
No siempre. Los modelos públicos pueden descargarse y ejecutarse localmente con Transformers sin crear un token de escritura. Para utilizar Inference Providers, modelos privados o determinados servicios alojados, sí necesitarás autenticarte con los permisos correspondientes. -
¿Qué modelo de Hugging Face sirve para transcribir audio en español?
Los modelos multilingües de Whisper son una opción habitual y admiten español. Comprueba siempre la ficha del checkpoint elegido, porque otros modelos ASR pueden estar entrenados para un solo idioma. -
¿Wav2Vec2 sirve para español?
La arquitectura Wav2Vec2 puede utilizarse para distintos idiomas si eliges un checkpoint adecuado. Sin embargo,facebook/wav2vec2-large-960h, utilizado en muchos ejemplos antiguos, está ajustado con LibriSpeech para inglés y no es el modelo indicado para transcribir español. -
¿Cómo transcribo archivos de audio largos con Hugging Face?
Con Transformers puedes utilizar fragmentación mediantechunk_length_s. El método exacto depende del modelo, por lo que conviene revisar también sus límites y recomendaciones antes de procesar grabaciones extensas. -
¿Qué conviene más para generar subtítulos: Hugging Face o Filmora?
Hugging Face ofrece más control técnico y es más adecuado para integrar modelos en aplicaciones. Filmora es más directo cuando quieres transcribir un video, revisar los subtítulos y continuar editando el contenido sin programar.